
PDF に含まれる画像を抽出して保存する
今回は保存してある PDF ファイルから、PDF に含まれている画像を抽出して画像ファイルとして保存する方法を解説します。
「PDF から画像を抽出します」アクションの詳細
Section titled “「PDF から画像を抽出します」アクションの詳細”今回使用するのは、「PDF から画像を抽出します」というアクションです。
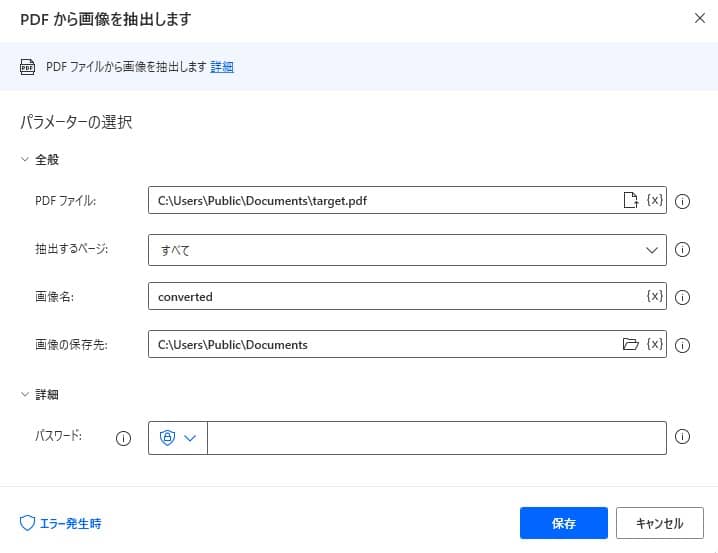
アクションは以下のパラメーターを持ちます。
| パラメーター名 | 値 |
|---|---|
| PDF ファイル | 画像を抽出する対象の PDF ファイルのパス |
| 抽出するページ | すべてのページ、単一のページ、ページの範囲のどれから画像を抽出するかを選択 |
| 画像名 | 抽出した画像のファイル名の先頭部分(「converted_1」「converted_2」のように連番が付きます) |
| 画像の保存先 | 抽出した画像(png 形式)を保存するフォルダー |
| パスワード | 「詳細」に表示される項目。PDF がパスワードで保護されている場合に指定します |
コピーアンドペーストで実装
Section titled “コピーアンドペーストで実装”今回はサンプルとして、パブリックのドキュメントに保存されている PDF ファイルから画像を抽出し、同じフォルダーに保存するフローを用意しました。
以下のコードをコピーし、Power Automate Desktop の編集画面に貼り付けることで、対象のアクションが追加されます。
Pdf.ExtractImagesFromPDF.ExtractImages PDFFile: $'''C:\\Users\\Public\\Documents\\target.pdf''' ImagesName: $'''converted''' ImagesFolder: $'''C:\\Users\\Public\\Documents'''Power Automate Desktop を操作して実装
Section titled “Power Automate Desktop を操作して実装”-
「アクションの検索」から、「PDF から画像を抽出」と入力します。
-
パラメーターを以下のように設定します。
パラメーター名 値 PDF ファイル C:\Users\Public\Documents\target.pdf 抽出するページ すべて 画像名 converted 画像の保存先 C:\Users\Public\Documents -
実行することで、指定した PDF ファイルから抽出した画像ファイルが、指定したフォルダーに保存されます。
起こりうる例外
Section titled “起こりうる例外”起こりうるエラーとして、まず PDF にパスワードがかかっている場合が挙げられます。パスワード付きの PDF であるにもかかわらず、パスワードが未設定の場合や、パスワードが異なっていた場合にはエラーとなります。
その他、指定した PDF ファイルや保存先フォルダーが存在しない場合や、PDF から画像をうまく抽出できなかった場合にもエラーとなります。
画像の抽出が必須ではない場合は、ブロック処理を実装しておくことをおすすめします。